Text-to-3D by Stitching a Multi-view Reconstruction Network to a Video Generator
一面挂满生成小世界的画廊墙,上方是利落的石板灰文字和一个粉色小勾。
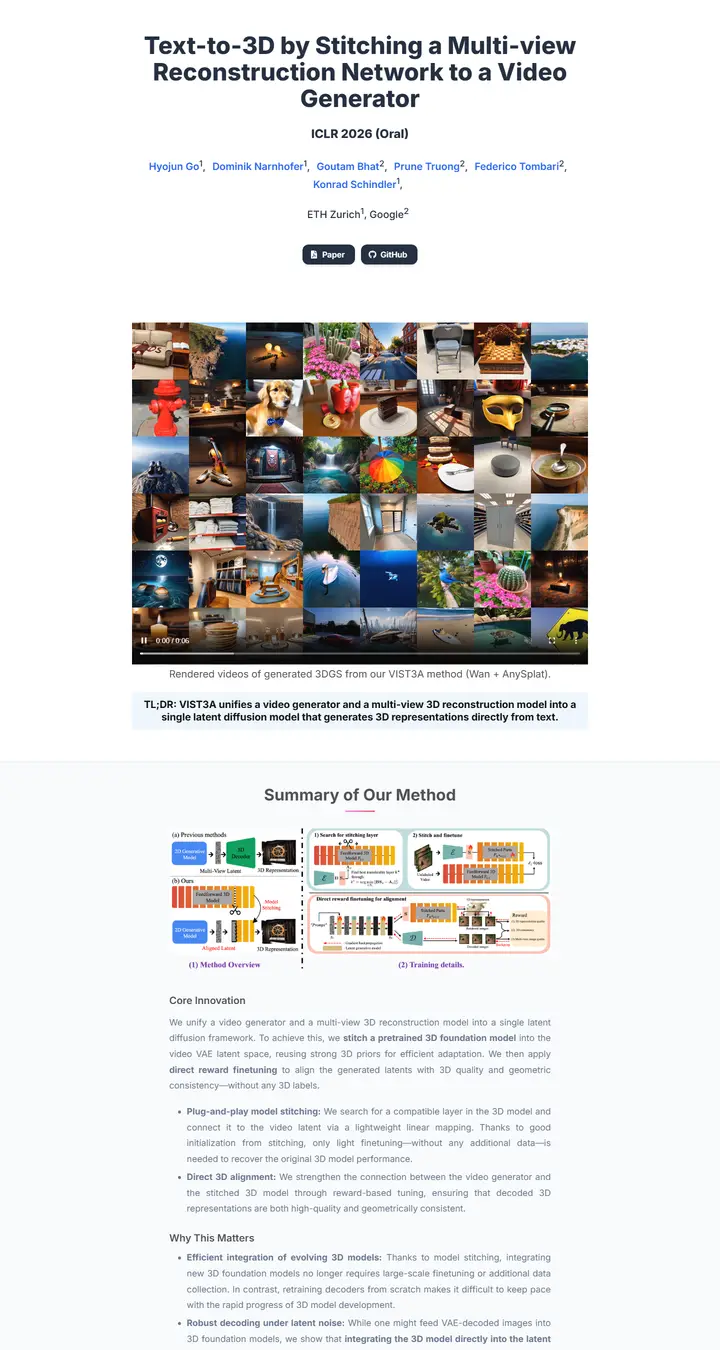
已对照实际渲染的页面核对。
入选理由
密集的生成结果拼贴视频做成了很抢眼的预告。下面依次是 TL;DR 提示框、浅色底的方法部分和标题下的强调下划线。字体克制,留白得当。
下面的说明和 DESIGN.md 正文是英文。为了让编程 agent 读同一个版本,这部分没有翻译。
概述
配色
字体
Inter
Text-to-3D by Stitching a Multi-view Reconstruction Network to a Video
Abstract · Method · Results · BibTeX — 0123456789
间距与形状
页面模块
使用建议
相似风格
GAMEBoT: Transparent Assessment of LLM Reasoning in Games
一块整洁的游戏竞技场记分牌,海军蓝标题上方是吉祥物徽章,下面冷灰蓝渐变色带里放着新闻卡和紫色表头的分数表。
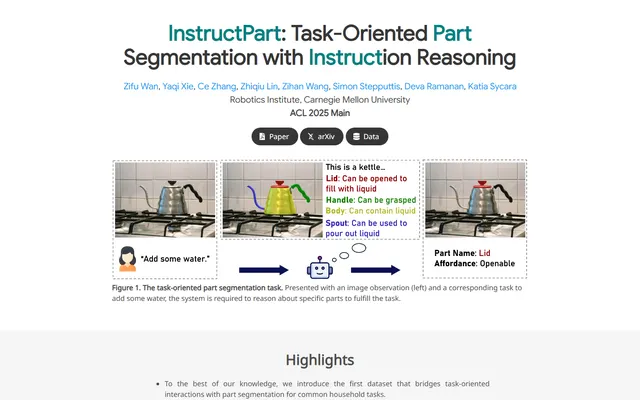
InstructPart: Task-Oriented Part Segmentation with Instruction Reasoning
一本灰白条纹的实验笔记,标题用青绿色标出自己的关键词,一只虚线框里的水壶在你读第一行之前就把任务讲明白了。
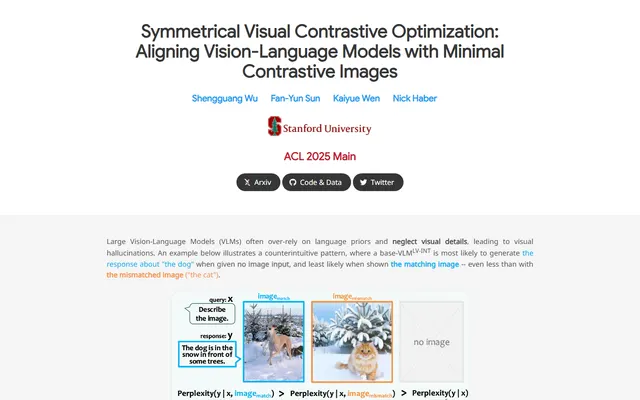
Symmetrical Visual Contrastive Optimization: Aligning Vision-Language Models with Minimal Contrastive Images
一套双色论证,青色代表匹配的图像,橙色代表不匹配的,这套色码从正文高亮一路延续到灰白交替色带上的每张图。
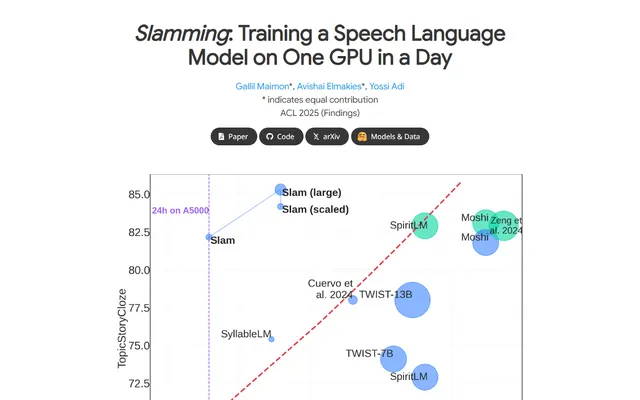
Slamming: Training a Speech Language Model on One GPU in a Day
一张图讲完的论证,本该放预告视频的位置是一张带注释的大号缩放曲线图,然后是灰色摘要,以及按 GPU 预算标注的一排排安静的音频播放器。
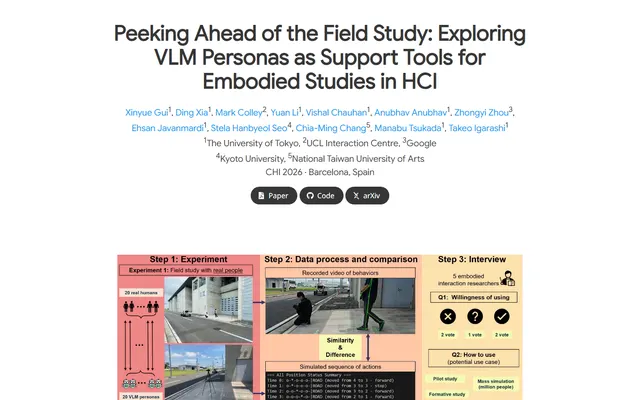
Peeking Ahead of the Field Study: Exploring VLM Personas as Support Tools for Embodied Studies in HCI
用胶带摊开在白桌上的野外笔记本,高挑的浅灰标题,一长串天蓝色的作者名,从鲑鱼色过渡到沙色的三格分镜讲清了整个研究。
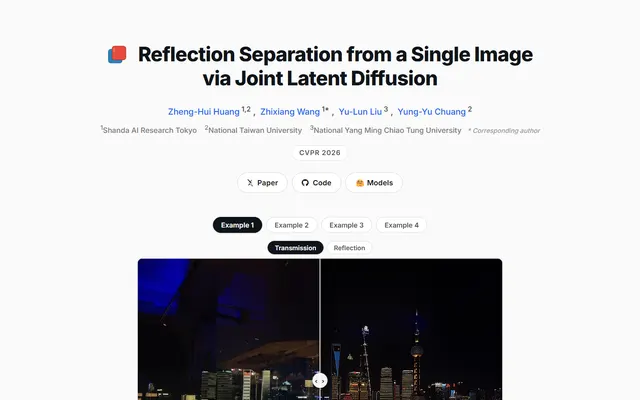
Reflection Separation from a Single Image via Joint Latent Diffusion
一块夜色玻璃,轻轻一拖就能擦净。