Vision-Language Models Create Cross-Modal Task Representations
一块博物馆墙上的展签,一种干净的字体,充裕的留白,以及一碰就会动起来的图示。
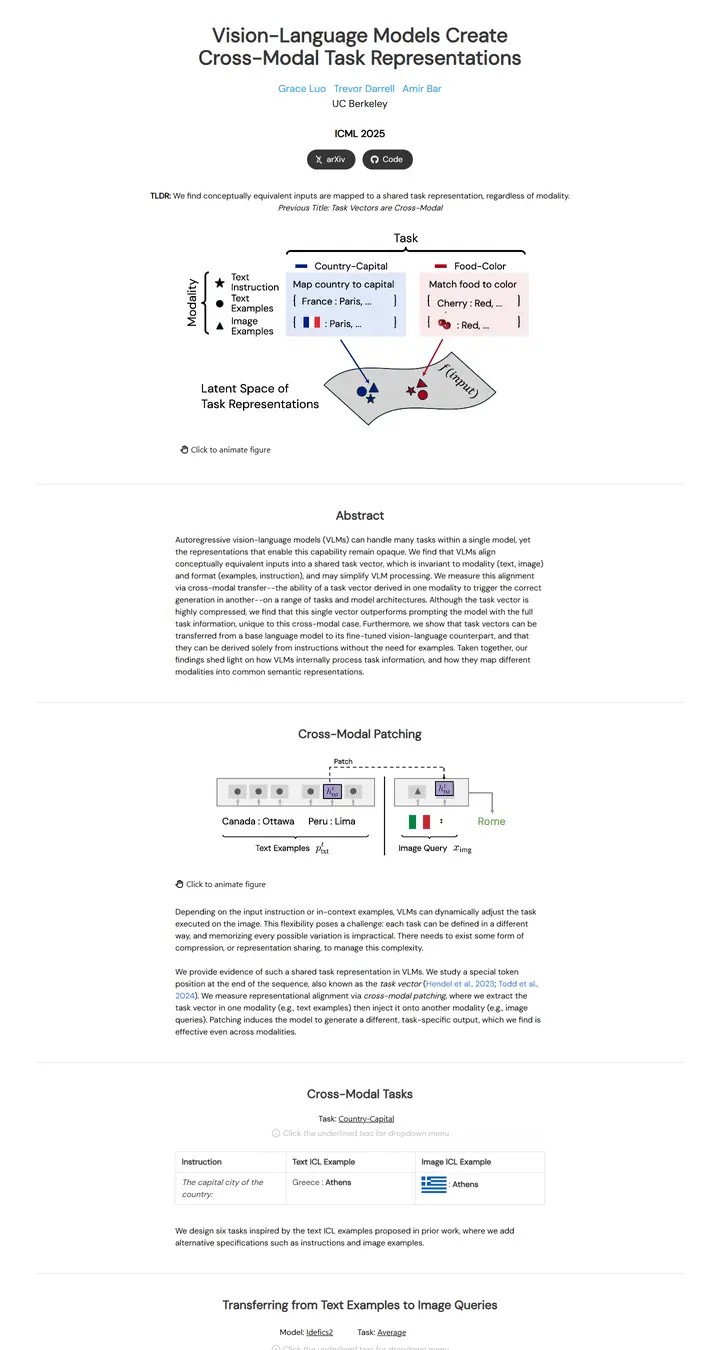
已对照实际渲染的页面核对。
入选理由
安静而精确。几何无衬线字体,居中的窄栏,各节之间的通栏细线分隔,点击即可播放动画的自制矢量预览图,以及小巧的内联下拉表格。留白运用得很优雅。
下面的说明和 DESIGN.md 正文是英文。为了让编程 agent 读同一个版本,这部分没有翻译。
概述
配色
字体
DM Sans
Vision-Language Models Create Cross-Modal Task Representations
Abstract · Method · Results · BibTeX — 0123456789
system stack for controls
Vision-Language Models Create Cross-Modal Task Representations
Abstract · Method · Results · BibTeX — 0123456789
间距与形状
页面模块
使用建议
相似风格
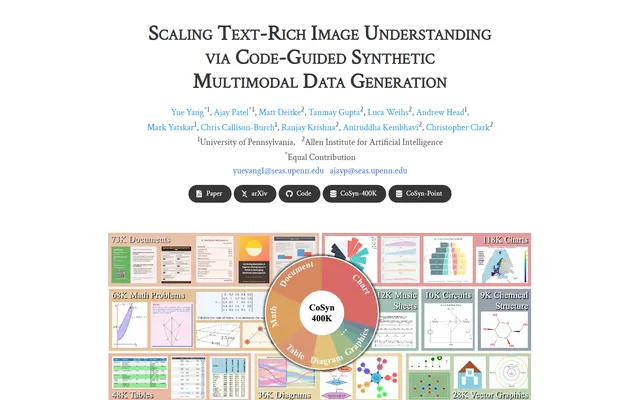
Scaling Text-Rich Image Understanding via Code-Guided Synthetic Multimodal Data Generation
一本大学出版社的目录册,小型大写衬线标题、色轮般排开的样本,还有一张大地色调的柱状图。
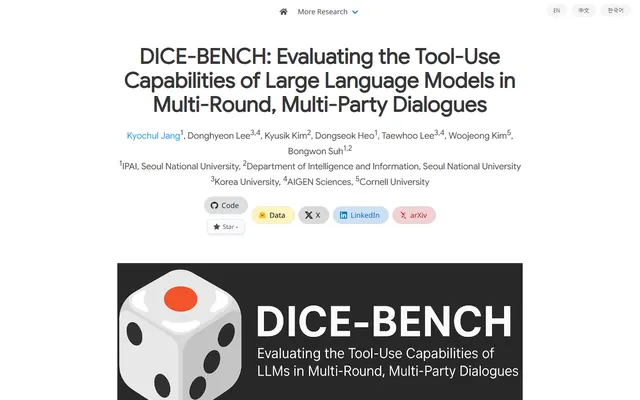
DICE-BENCH: Evaluating the Tool-Use Capabilities of Large Language Models in Multi-Round, Multi-Party Dialogues
一张套着桌游盒封面的 Nerfies 页面,炭灰色骰子横幅打下身份印记,粉彩品牌色胶囊按钮和灰色轮播条把你带进安静的双栏方法解读。
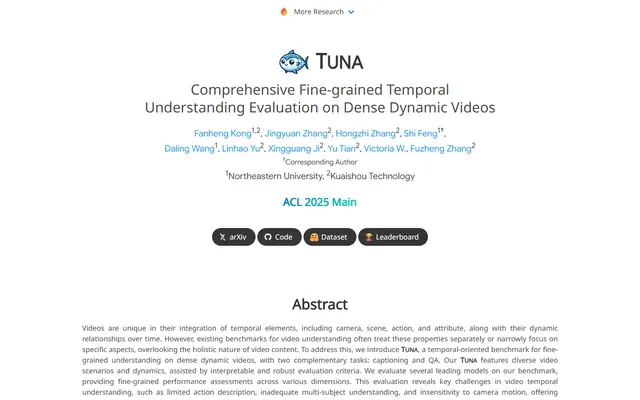
TUNA: Comprehensive Fine-grained Temporal Understanding Evaluation on Dense Dynamic Videos
一个先亮记分牌的 benchmark,带鱼形标志的小型大写字标、渐变色会议名一行,然后是灰色表头、斑马纹行和蓝色模型链接的通栏排行榜。
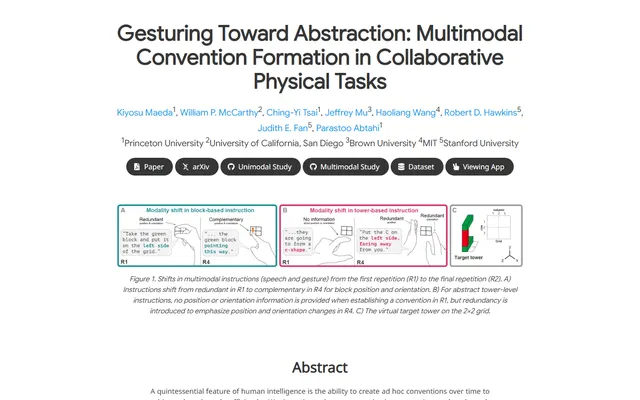
Gesturing Toward Abstraction: Multimodal Convention Formation in Collaborative Physical Tasks
印在干净纸上的研讨课讲义,大号柔和标题,六个炭灰色标签,一条青绿与洋红的连环画,画着双手在讲解积木。
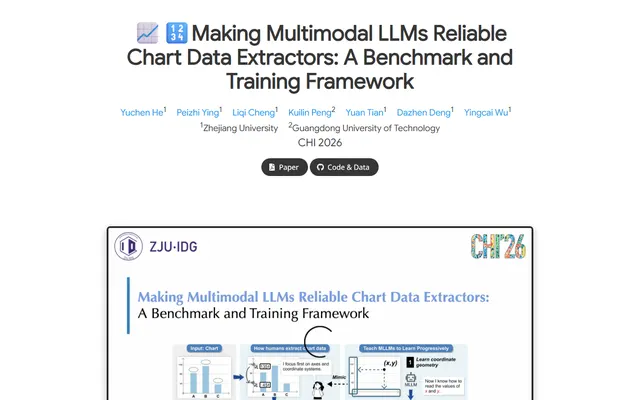
Making Multimodal LLMs Reliable Chart Data Extractors: A Benchmark and Training Framework
翻到最得意一页的实验笔记本,视频像装在显示器边框里,标题里有 emoji,每张图都带着柔和阴影钉在页上。
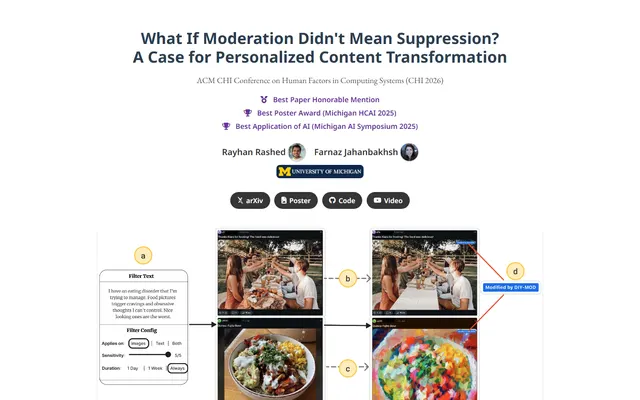
What If Moderation Didn't Mean Suppression? A Case for Personalized Content Transformation
一间安静的阅览室,讲台上搭着紫色缎带,石板灰的无衬线标题,Garamond 正文,墙上钉着一张暖琥珀色的便条。